Los equipos no tienen un problema de datos. Tienen un problema de integración.
AWS Glue 6.0 bajó 30% el precio de procesamiento y cambió la forma de construir pipelines. Le explicamos qué significa eso para el presupuesto y los plazos de su área de datos.
 Ivan Lima · Experto en Transformación Digital
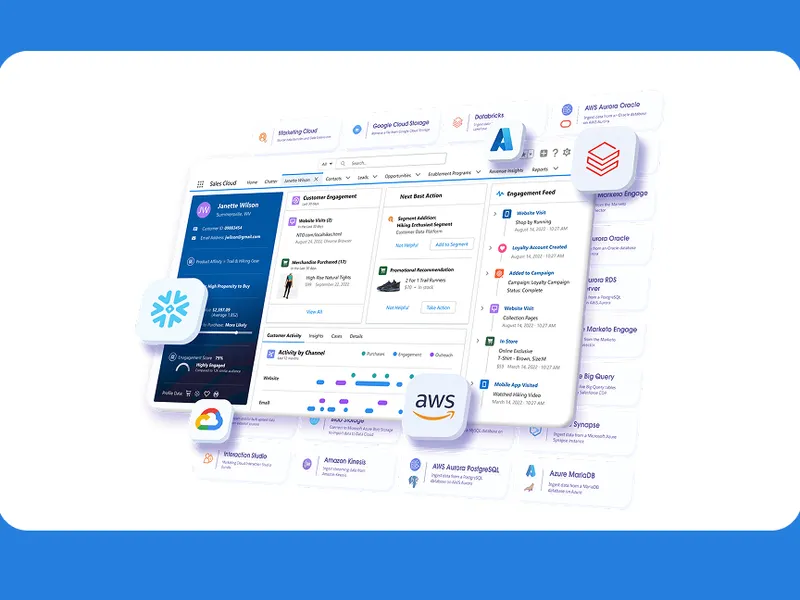
Si trabaja en analítica, machine learning o desarrollo de aplicaciones, conoce la escena: el proyecto se aprueba, el equipo se entusiasma y luego pasan semanas descubriendo dónde viven los datos, quién los mantiene y por qué el campo customer_id significa tres cosas distintas según el sistema.
El modelo no se retrasa por falta de talento. Se retrasa porque los datos llegan tarde, incompletos y sin contexto.
Ahí es donde entra AWS Glue: el servicio serverless de integración de datos de AWS que descubre, prepara, mueve y combina información de múltiples orígenes sin que usted administre un solo servidor. Y en su versión 6.0, disponible desde agosto de 2026, la propuesta cambió lo suficiente como para revisar la arquitectura que tiene hoy.
-30% en el precio de procesamiento frente a versiones anteriores · +60 conectores nativos, más lectura de cualquier API REST · latencias de un solo dígito en milisegundos en streaming sin estado
El costo silencioso de mover datos
Antes de hablar de la herramienta, vale la pena poner nombre al problema. En la mayoría de las organizaciones con las que trabajamos, el costo de la integración de datos se reparte en tres lugares donde nadie lo mide.
Costo 1: Tiempo de ingeniería. Escribir y mantener código de orquestación, conectores a medida y lógica de reintentos. Trabajo que no diferencia al negocio y que consume a los perfiles más caros del equipo.
Costo 2: Infraestructura ociosa. Clústeres de Spark encendidos “por si acaso”, dimensionados para el pico de fin de mes y facturando el resto del tiempo.
Costo 3: Decisiones tomadas a ciegas. Cuando un analista no encuentra la tabla correcta, no deja de decidir: decide con la tabla equivocada.
Los tres se corrigen con la misma palanca: una capa de integración administrada, con un catálogo confiable en el centro.
Qué hace AWS Glue por su operación
AWS Glue reúne en un solo servicio lo que normalmente son cuatro proyectos separados:
- Catálogo de datos. Un registro central de esquemas y metadatos que Amazon Athena, Amazon Redshift, Amazon EMR y sus notebooks consultan como fuente única de verdad.
- Descubrimiento automático. Los crawlers recorren sus orígenes, infieren el esquema y lo registran sin intervención manual.
- ETL sin servidores. Los trabajos se ejecutan sobre Apache Spark administrado, con cobro por segundo de uso.
- Conectividad amplia. Más de 60 conectores nativos y, desde el conector REST nativo lanzado en febrero de 2026, la posibilidad de leer cualquier origen que exponga una API REST sin empaquetar librerías propias.
Traducido al lenguaje del comité de inversión, el cambio es de modelo de gasto:
Modelo tradicional: paga por lo que aprovisiona. Clústeres dimensionados para el peor escenario, encendidos todo el mes y facturando aunque nadie los use.
Modelo serverless: paga por lo que procesa. Cobro por segundo de ejecución, sin infraestructura que administrar ni capacidad ociosa en la factura.
Qué cambia con AWS Glue 6.0
La versión 6.0 llegó con un runtime modernizado (Apache Spark 4.1, Python 3.13, Scala 2.13) y cinco cambios con efecto directo en costos y plazos.
1. Treinta por ciento menos en el precio de procesamiento
Es la noticia que abre cualquier conversación de presupuesto. La misma carga de trabajo recurrente cuesta un tercio menos que en versiones anteriores. Para una empresa con pipelines diarios de consolidación, eso reordena el caso de negocio de todo el lakehouse.
2. Soporte completo de Apache Iceberg v3
AWS Glue 6.0 implementa la especificación v3 completa de Apache Iceberg, con efectos concretos sobre el esquema y la portabilidad de sus tablas. Lo relevante para su equipo:
- Tipo de dato VARIANT con shredding: almacene y consulte JSON, logs y eventos sin aplanar el esquema. Se acaban las copias duplicadas, el código de parseo a medida y los pipelines que se rompen cada vez que un sistema origen agrega un campo.
- Tipos geometry y geography: analítica espacial e inteligencia de ubicación de forma nativa, sin librerías externas.
- Timestamps de precisión de nanosegundos: para telemetría IoT, cómputo científico y operaciones financieras de alta frecuencia.
- Manejo de tipos desconocidos: los esquemas que evolucionan río arriba dejan de tumbar el proceso río abajo.
Además, una tabla escrita en formato Iceberg puede consultarse desde otros motores del ecosistema sin migrar datos. Eso reduce el riesgo de quedar atado a un proveedor.
3. Spark Declarative Pipelines
Su equipo declara cómo deben verse los datos y el motor decide el orden de ejecución. Menos código de orquestación escrito a mano significa menos superficie para errores y una curva de entrada más corta para los ingenieros que se suman al proyecto.
4. UDFs de Python nativas en Arrow
Las funciones definidas por el usuario ya no pagan el costo de serialización entre Python y la JVM. Las transformaciones complejas en PySpark terminan antes, y las ventanas nocturnas de procesamiento se acortan.
5. Modo de streaming en tiempo real
Para casos de uso sin estado, AWS Glue 6.0 alcanza latencias de milisegundos de un solo dígito. Detección de fraude, ruteo de eventos y personalización en vivo dejan de necesitar una arquitectura aparte.
Un detalle que suele decidir la migración: no hay cambios de API. Se selecciona la versión desde la consola, la CLI o el SDK, y existe un agente de actualización para llevar trabajos existentes a la nueva versión.
El catálogo también entiende el negocio
En junio de 2026, AWS lanzó en versión preliminar el contexto de negocio y la búsqueda semántica para el Catálogo de Datos de Glue. Ahora puede enriquecer sus tablas con términos de glosario y campos de metadatos propios, y buscar información por significado y no solo por nombre de columna.
Para quienes están montando agentes de IA sobre sus datos, el agente responde con definiciones aprobadas por el negocio en lugar de inferirlas.
Tres escenarios donde esto se traduce en resultados
Escenario 1: Analítica. Un catálogo unificado sobre Amazon S3 permite que finanzas, operaciones y comercial consulten el mismo dato con Athena o Redshift. Se acaba la reunión donde cada área llega con su propia cifra de ventas.
Escenario 2: Machine learning. El feature engineering deja de depender de extracciones manuales. Los datos llegan versionados, con linaje y con control de acceso granular vía AWS Lake Formation.
Escenario 3: Desarrollo de aplicaciones. Los equipos de producto consumen datos gobernados a través de APIs y tablas Iceberg, sin construir su propia canalización por cada funcionalidad nueva.
Cómo lo implementamos
Trabajamos en cuatro fases, con entregables verificables en cada una.
- Diagnóstico (1 a 2 semanas). Inventario de orígenes, mapa de flujos actuales y costeo de la operación vigente. Usted termina esta fase sabiendo cuánto gasta hoy en integración.
- Diseño del lakehouse. Definición del modelo de datos, formato de tabla, políticas de gobierno y estimación de costos con AWS Glue 6.0.
- Implementación por dominios. Empezamos por el caso de uso con mayor retorno, lo dejamos en producción y desde ahí escalamos. Nada de proyectos de doce meses sin resultados intermedios.
- Transferencia y acompañamiento. Su equipo queda operando la plataforma. Nosotros quedamos como respaldo, no como dependencia.
Preguntas que nos hacen antes de empezar
“¿Tenemos que reescribir nuestros trabajos actuales?” No. AWS Glue 6.0 no exige cambios de API, y el agente de actualización para Spark asiste en la migración de los trabajos existentes.
“Ya usamos otra plataforma de datos, ¿esto la reemplaza?” No necesariamente. Al escribir en Apache Iceberg, sus tablas siguen siendo consultables desde otros motores. La decisión deja de ser todo o nada.
“¿Cómo controlamos quién ve qué?” Con AWS Lake Formation aplicando control de acceso granular, incluido el control sobre operaciones de escritura.
“¿Cuánto tarda en verse el primer resultado?” En nuestros proyectos, el primer dominio de datos entra en producción dentro del primer trimestre. El diagnóstico entrega números antes de que usted firme la implementación.
Empiece por saber cuánto le cuesta hoy
Antes de mover un solo pipeline, conviene tener el número sobre la mesa. Nuestro equipo certificado en AWS realiza un diagnóstico de integración de datos sin costo: revisamos su arquitectura actual, identificamos las cargas que más consumen presupuesto y le entregamos una estimación de ahorro con AWS Glue 6.0.
Son 45 minutos con un arquitecto, no con un vendedor.
También te puede interesar
Arquitectura SecOps 2.0: Cómo los Agentes de Microsoft Security Copilot Redefinen la Defensa Autónoma
3 de julio de 2026
Leer Más
El Espejismo de la IA Reactiva: Arquitecturas Agénticas para Escalar Operaciones Complejas
6 de julio de 2026
Leer Más
El espejismo de la productividad: Por qué usar IA no está aumentando tus ganancias (y cómo solucionarlo)
28 de julio de 2026
Leer Más